Publications by Liv G. d'Aliberti on reinforcement learning, AI reasoning, interpretable decision-making, privacy-preserving computation, and applied machine learning.
For illustrated explanations of selected papers, including their findings, figures, and methods, visit Research explained.
Introduces ModeBench to measure solution diversity under RLVR and Re:Max, a replay method that practices verified modes uniformly to preserve diverse correct solutions.
@inproceedings{daliberti2026measuringmitigatingsolutionmodecollapse,title={Measuring and Mitigating Solution Mode Collapse in RLVR},author={d'Aliberti, Liv G. and Abdulhai, Marwa and Druchyna, Sofiia and Henderson, Peter and Horta Ribeiro, Manoel},booktitle={The 6th Workshop on Mathematical Reasoning and AI at NeurIPS 2026},year={2026},month=dec,eprint={2610.11064},archiveprefix={arXiv},primaryclass={cs.LG},url={https://arxiv.org/abs/2610.11064},paper={https://arxiv.org/abs/2610.11064},note={Accepted to MATH-AI at NeurIPS 2026},}
@inproceedings{hussing2026behaviorconsistentdeepreinforcementlearning,title={Behavior-Consistent Deep Reinforcement Learning},author={Hussing, Marcel and d'Aliberti, Liv G. and Voelcker, Claas and Eysenbach, Benjamin and Eaton, Eric},booktitle={Workshop on Automated Reinforcement Learning at RLC},year={2026},month=aug,eprint={2605.21214},archiveprefix={arXiv},primaryclass={cs.LG},url={https://arxiv.org/abs/2605.21214},post={https://x.com/livdaliberti/status/2057876641653670026},note={Accepted},}
@inproceedings{daliberti2026illusioninsightreasoningmodels,title={The Illusion of Insight in Reasoning Models},author={d'Aliberti, Liv G. and Horta Ribeiro, Manoel},booktitle={Findings of the Association for Computational Linguistics: ACL 2026},year={2026},month=jul,address={San Diego, California, United States},publisher={Association for Computational Linguistics},pages={924--966},doi={10.18653/v1/2026.findings-acl.47},eprint={2601.00514},archiveprefix={arXiv},primaryclass={cs.AI},url={https://aclanthology.org/2026.findings-acl.47/},paper={https://aclanthology.org/2026.findings-acl.47/},post={https://x.com/manoelribeiro/status/2008261102853857393},}
@inproceedings{11068676,author={Clark, Christian A. and Albarado, Kevin M. and Wilson, Joshua P. and Bernard, Cedric A. and Scott, Jackson D. and D'Aliberti, Liv},booktitle={2025 IEEE Aerospace Conference},title={Explainability for Unmanned Aerial Vehicle Control via Multi-Objective Reinforcement Learning},year={2025},volume={},number={},pages={1-15},keywords={Training;Command and control systems;Visualization;Reinforcement learning;Production;Autonomous aerial vehicles;Robustness;Fuels;Standards;Optimization},doi={10.1109/AERO63441.2025.11068676},paper={https://ieeexplore.ieee.org/document/11068676},}
BlindFL: Segmented Federated Learning with Fully Homomorphic Encryption
E. Gronberg , L. d’Aliberti , M. Saebo, and 1 more author
@article{daliberti2022privacy_preservation,title={Preserving Patient Privacy during Computation over Shared Electronic Health Record Data},author={d’Aliberti, L. and Clark, M.},journal={Springer Nature Journal of Medical Systems},year={2022},doi={10.1007/s10916-022-01865-5},}
Hyperdimensional Computing Encoding Schemes for Improved Image Classification
V. Miranda and L. d’Aliberti
IEEE 2022 International Symposium on Technologies for Homeland Security, Jul 2022


 Privacy-Enhancing Technologies for AI Systems: A TutorialIn Proceedings of the 10th ACM International Workshop on Security and Privacy Analytics, Porto, Portugal, Jul 2024
 Large Language Model Inference over Confidential Data Using AWS Nitro EnclavesAWS Machine Learning Blog, Jul 2024


 Enabling Fully Homomorphic Encryption with Amazon SageMaker Endpoints for Secure, Real-Time InferencingAWS Machine Learning Blog, Jul 2023
 Privacy-Enhancing Technologies: Protecting Data In UseLeidos Insights Blog, Jul 2023
 Leidos Researchers Compete to Develop the Best Unmanned Surface Vessel ModelsLeidos Insights Blog, Jul 2023


 Hyperdimensional Computing Encoding Schemes for Improved Image ClassificationIEEE 2022 International Symposium on Technologies for Homeland Security, Jul 2022


 Effects of a Resident-Led Subject Exam Review on Mean Scores of Internal Medicine Subject Exam: A Case-Control StudyMed. Scie. Edu., Jul 2020
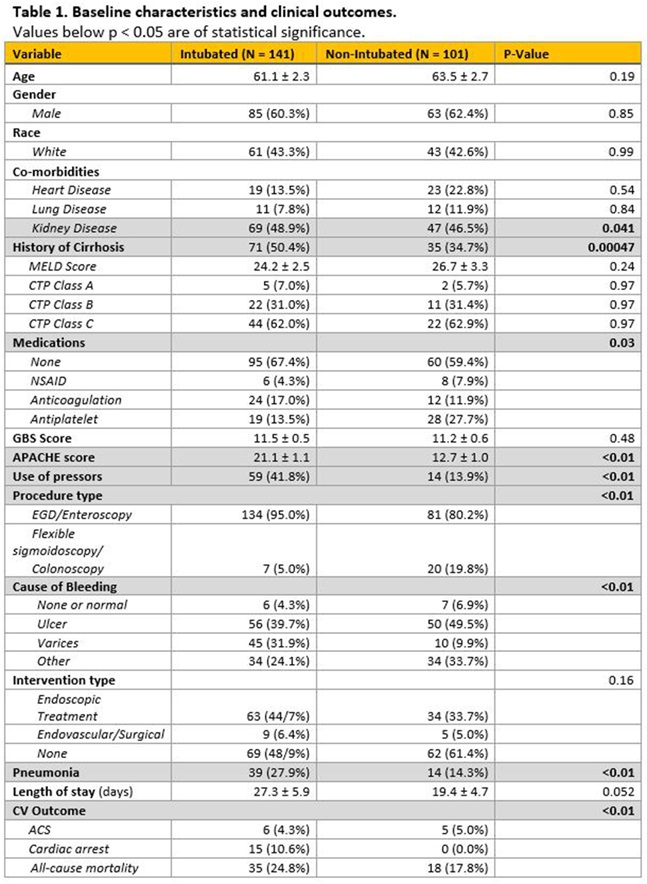 Pre-Endoscopic Intubation for Emergent GI Bleeding Associated With Increased Adverse OutcomesThe American Journal of Gastroenterology, Jul 2020

